


NVIDIA Vera Rubin NVL72
Supermicro 的 NVIDIA Vera Rubin NVL72 旨在提供當今 agentic AI 工作負載所需的 Token 吞吐量,其每瓦產生的吞吐量高達 NVIDIA Blackwell 的 10 倍。隨著前沿模型的不斷發展,NVIDIA Vera Rubin 平臺同時大幅提升了 72 個 Rubin GPU 與 36 個 Vera CPU 的 GPU 記憶體、NVLink™ 以及 Networking 頻寬。Supermicro 的 Data Center Building Block Solutions® 能有效加速上線時間。
Vera Rubin NVL72
液冷機架式解決方案
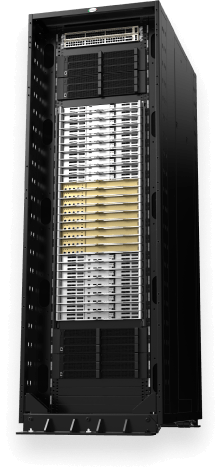
配備 72 個水冷 NVIDIA Rubin GPU 和 36 個 NVIDIA Vera CPU 的機架式 AI

2U NVIDIA HGX Rubin 系統
這款 2U HGX Rubin 系統提供了密度最高且最具彈性的 HGX 平台,同時也是首款在CPU 提供更高彈性的 HGX 平台,不僅支援 NVIDIA Vera ,還包含新一代AMD Intel x86 處理器。 該系統基於 NVIDIA MGX 機架架構打造,並採用Supermicro盲插匯流排與集流器,實現免工具機架整合,讓客戶能夠自由地將八顆Rubin 與最適合其工作負載和軟體堆疊的CPU 進行搭配。
2U液冷系統
適用於 NVIDIA HGX Rubin NVL8

專為 NVIDIA MGX 機架架構設計的前置 I/O 水冷系統,配備 Supermicro 的盲插式匯流排

NVIDIA Vera CPU 機架
Supermicro 的氣冷式和 100% 直接液冷式機架解決方案採用 NVIDIA Vera CPU 驅動 — 這是一個完全整合的系統,旨在處理規模化代理式 AI 的新興需求以及最嚴苛的 HPC 模擬工作負載。氣冷式配置在單一 48U 機架中支援高達 64 個 Vera CPU,而液冷式配置則包含 256 個液冷式 NVIDIA Vera CPU,擁有高達 22,528 個核心。憑藉高達 300TB/s 的總記憶體頻寬,Vera CPU 機架專為提供強化學習和代理式 AI 工作負載所需的預測性傳輸量而建構,同時還能在需要高併發性時公開額外的執行緒。作為完整基礎架構堆疊所設計,旨在為 AI 和 HPC 資料中心最大化密度、效率和可部署性,這些配置受到 Supermicro 第二代先進直接液冷技術 DLC-2 的支援,可實現近乎全面的熱能捕捉與機架級整合,從而實現高於傳統 CPU 的每機架核心密度。

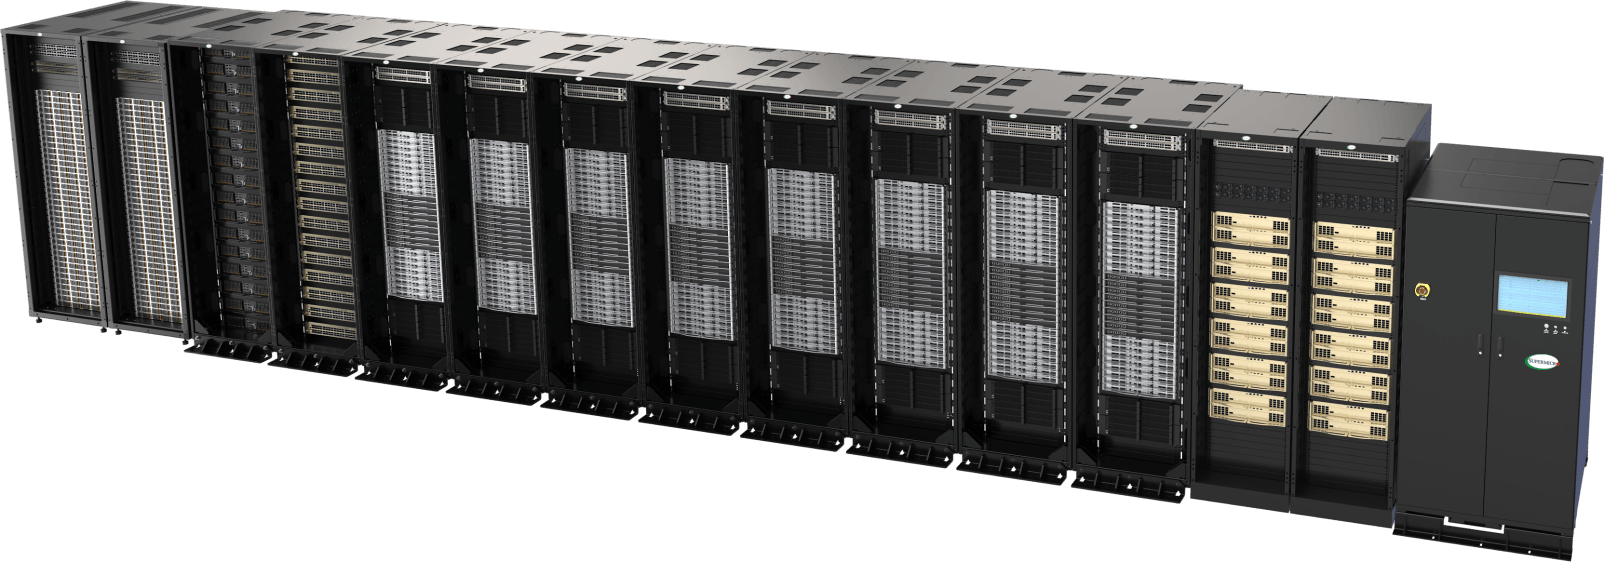
適用於 NVIDIA Vera Rubin NVL72 的 DCBBS 架構藍圖
從 5MW 到 1GW 的可擴充設計
- 每個 5MW 功耗範圍內配備完整的 1,152-GPU NVIDIA Vera Rubin NVL72 可擴充單元,並可從單一單元擴充至吉瓦級(gigawatt-class)AI 工廠
- 每個可擴充單元 (Scalable Unit) 提供 331 TB 的 HBM4 GPU 記憶體*與 864 TB 的 LPDDR5X CPU 記憶體,可透過 NVLink™ 架構進行一致性存取
- 業界領先的 DLC-2 直接式液冷技術,從晶片直接冷卻冷板到 1MW 冷卻塔,適用於每機架 227 kW 的規模
- 涵蓋完整生命週期的專屬 Supermicro 團隊:現場勘查、專案設計、整合、部署與持續支援
- 支援 NVIDIA 最新參考架構,整合 NVIDIA Context Memory Storage Platform、NVIDIA Spectrum™-X 乙太網路與 NVIDIA Quantum-X800 infiniBand 平台
- 管理軟體套件:端到端的 SuperCloud 軟體提供統一的基礎架構控制、部署自動化、開發人員工具以及多租戶 GPU 雲端管理
* 實體 GPU 記憶體
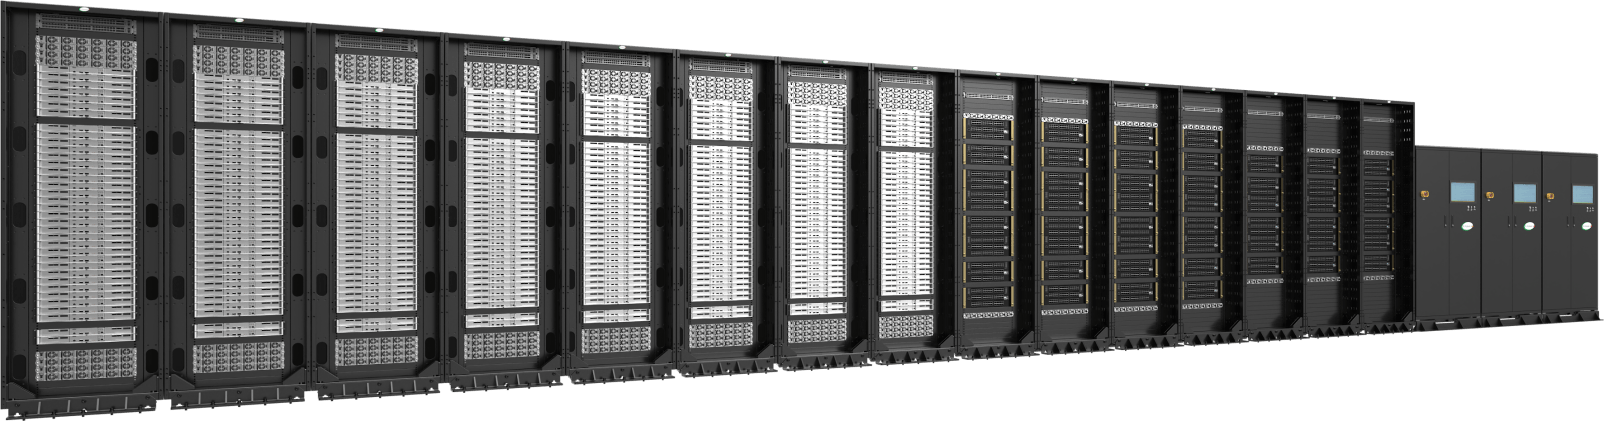
適用於 NVIDIA Vera Rubin NVL4 的 DCBBS 架構藍圖
適用於融合式 HPC 與 AI 基礎架構的原生 FP64 效能
- 完整的 1,152-GPU NVIDIA Vera Rubin NVL4 可擴充系統,可從單一可擴充單元倍增至吉瓦級(gigawatt)HPC 與 AI 部署規模
- 每個可擴展單元(Scalable Unit)具備 331 TB 的 HBM4 GPU 記憶體*與 864 TB 的 LPDDR5X CPU 記憶體,且每個 NVL4 節點具備超過 4 TB 的一致性記憶體
- 業界領先的 DLC-2 直接液冷技術,每機櫃支援高達 360 kW 的散熱容量,並透過具備 2+1 備援機制的 1.8 MW 行間 CDU 進行冷卻
- 涵蓋運算、儲存、網路、電源、冷卻和站點基礎架構的全端式單一供應商解決方案
- 涵蓋完整生命週期的專屬 Supermicro 團隊:現場勘查、專案設計、整合、部署與持續支援
- 針對 NVIDIA 參考架構進行優化的 HPC 與 AI 計算組織,採用 NVIDIA Quantum-X800 InfiniBand
- 管理軟體套件:端到端的 SuperCloud 軟體提供統一的基礎架構控制、部署自動化、開發人員工具以及多租戶 GPU 雲端管理
* 實體 GPU 記憶體
立即與我們聯繫,開始您的新一代AI資料中心設計。